צ׳אטבוט על מסמכי החברה: איך בונים עוזר AI שעונה מהידע של העסק, עם מקורות
איך עובד עוזר AI שעונה מתוך מסמכי החברה (RAG), למה זה לא ״אימון״, איך מכינים מסמכים, הרשאות, ציטוט מקורות, בדיקות, אבטחה ורשימת בדיקה.
מתוך המדריך: אוטומציה עסקית עם AI: המדריך המלא לעסקים בישראל
צ׳אטבוט על מסמכי החברה הוא עוזר AI שעונה על שאלות מתוך המסמכים של העסק עצמו: נהלים, חוזים, מחירונים, מדריכי מוצר ותשובות שכבר נכתבו. הוא לא ״לומד״ את המסמכים במובן של אימון מודל. בכל שאלה הוא מחפש את הקטעים הרלוונטיים, נותן אותם למודל השפה ומבקש ממנו לענות רק מהם, עם הפניה למקור. השיטה נקראת RAG, והיא מה שמאפשר לבדוק כל תשובה ולעדכן את הידע בלי לבנות מחדש.
המאמר עוסק בבנייה של עוזר כזה: איך RAG עובד, איך מכינים את המסמכים, איך שומרים על הרשאות, איך בודקים לפני שעולים, מה עושים כשאין תשובה, ואיך מגינים עליו. ההבדל בין בוט לפי חוקים, צ׳אטבוט מבוסס מודל שפה וסוכן שמבצע פעולות מוסבר בצ׳אטבוט או סוכן AI, ואיך עוזר על ידע משתלב בשאר האוטומציה בעסק, במדריך לאוטומציה עסקית.
איך עובד עוזר AI על מסמכי החברה?
RAG הוא קיצור של Retrieval-Augmented Generation: יצירת תשובה שנשענת על אחזור מידע. השיטה תוארה ב־2020 במאמר של Lewis ושותפים, שהציג אותה בין השאר כדרך לתת מקור לתשובות של מודל שפה. בעסק זה עובד בשני שלבים:
- הכנה, פעם אחת ובכל עדכון: המסמכים מחולקים לקטעים, כל קטע מקבל ייצוג מספרי שמתאר את המשמעות שלו (embedding), והכול נשמר באינדקס שאפשר לחפש בו לפי משמעות ולא רק לפי מילים.
- בכל שאלה: המערכת מחפשת באינדקס את הקטעים הקרובים ביותר לשאלה, מסננת לפי מה שהמשתמש רשאי לראות, ושולחת אותם למודל עם הוראה לענות רק מהם ולציין מאיזה מסמך כל חלק בתשובה.
היתרון: התשובה נשענת על טקסט שאפשר להראות. כשמסמך משתנה, מעדכנים את האינדקס, והתשובה הבאה כבר משקפת את השינוי.
״מאומן על המסמכים שלנו״: אחזור, לא אימון
הרבה הצעות מדברות על ״מודל שאומן על הידע של החברה״. ברוב המקרים הכוונה ל־RAG, וזה טוב. אימון אמיתי (fine-tuning) משנה את המודל עצמו, והוא מתאים ללמד סגנון, פורמט או משימה חוזרת, לא לזכור עובדות שמשתנות.
| אחזור (RAG) | אימון (Fine-tuning) | |
|---|---|---|
| מה משתנה | האינדקס של המסמכים. המודל נשאר כמו שהוא | המשקלים של המודל |
| עדכון ידע | מעדכנים מסמך ומאנדקסים מחדש | צריך לאמן שוב |
| מקור לכל תשובה | כן, אפשר להראות מאיזה קטע | לא, הידע ״בתוך״ המודל |
| הרשאות לפי משתמש | אפשר לסנן מה נשלף לכל משתמש | קשה מאוד: מה שנלמד זמין לכולם |
| מתאים ל | שאלות על נהלים, חוזים, מוצרים ומדיניות | סגנון כתיבה קבוע, פורמט, סיווג |
כשספק אומר ״אימון״, כדאי לשאול ישירות: האם התשובות מציגות מקור, ומה קורה כשמסמך מתעדכן מחר בבוקר.
הכנת המסמכים: שם מתחילה האיכות
העוזר טוב בדיוק כמו החומר שהוא עונה ממנו. רוב העבודה בפרויקט כזה היא לא בקוד אלא במסמכים:
- גרסה אחת לכל נושא: שלושה נהלים שסותרים זה את זה ייתנו שלוש תשובות. מוחקים או מסמנים גרסאות ישנות.
- בעלות ותאריך: לכל מסמך יש אחראי ותאריך עדכון, כדי שאפשר יהיה לדעת מה עדכני.
- טקסט שאפשר לקרוא: PDF סרוק בלי שכבת טקסט, טבלאות כתמונה וקבצים מוגנים צריכים המרה. כדאי לבדוק איך כל סוג קובץ נקרא לפני שמכניסים אלפים.
- מבנה ברור: כותרות, סעיפים ממוספרים ושם מסמך שמתאר אותו עוזרים לחיתוך לקטעים ולציטוט.
- מה לא נכנס: מסמכים עם מידע אישי שלא נחוץ לתשובות, טיוטות ותכתובות פנימיות רגישות.
הרשאות: כל משתמש רואה רק את מה שמותר לו
בעוזר פנימי זו הדרישה החשובה ביותר ואחת שנשכחת הכי הרבה. אם העוזר מחפש בכל המסמכים עבור כל מי ששואל, עובד שלא רשאי לראות חוזה של לקוח מסוים יקבל ממנו ציטוט. OWASP, שמפרסם רשימת סיכונים נפוצה ליישומי מודלי שפה, מונה את זה תחת חולשות של וקטורים ו־embeddings: גישה לא מורשית ודליפה בין קבוצות משתמשים כשבקרת הגישה לא מיושרת, וממליץ על אינדקס שמודע להרשאות ועל חלוקה לוגית של הנתונים.
בפועל: ההרשאות נאכפות בשלב האחזור, לפי מי שמחובר, ומשקפות את ההרשאות שכבר קיימות בכונן או במערכת המסמכים. לא מסתמכים על הוראה למודל ״אל תראה מסמכים חסויים״, כי המודל יכול להיות מוטעה או מנוצל.
ציטוט מקורות: כל תשובה מראה מאיפה היא באה
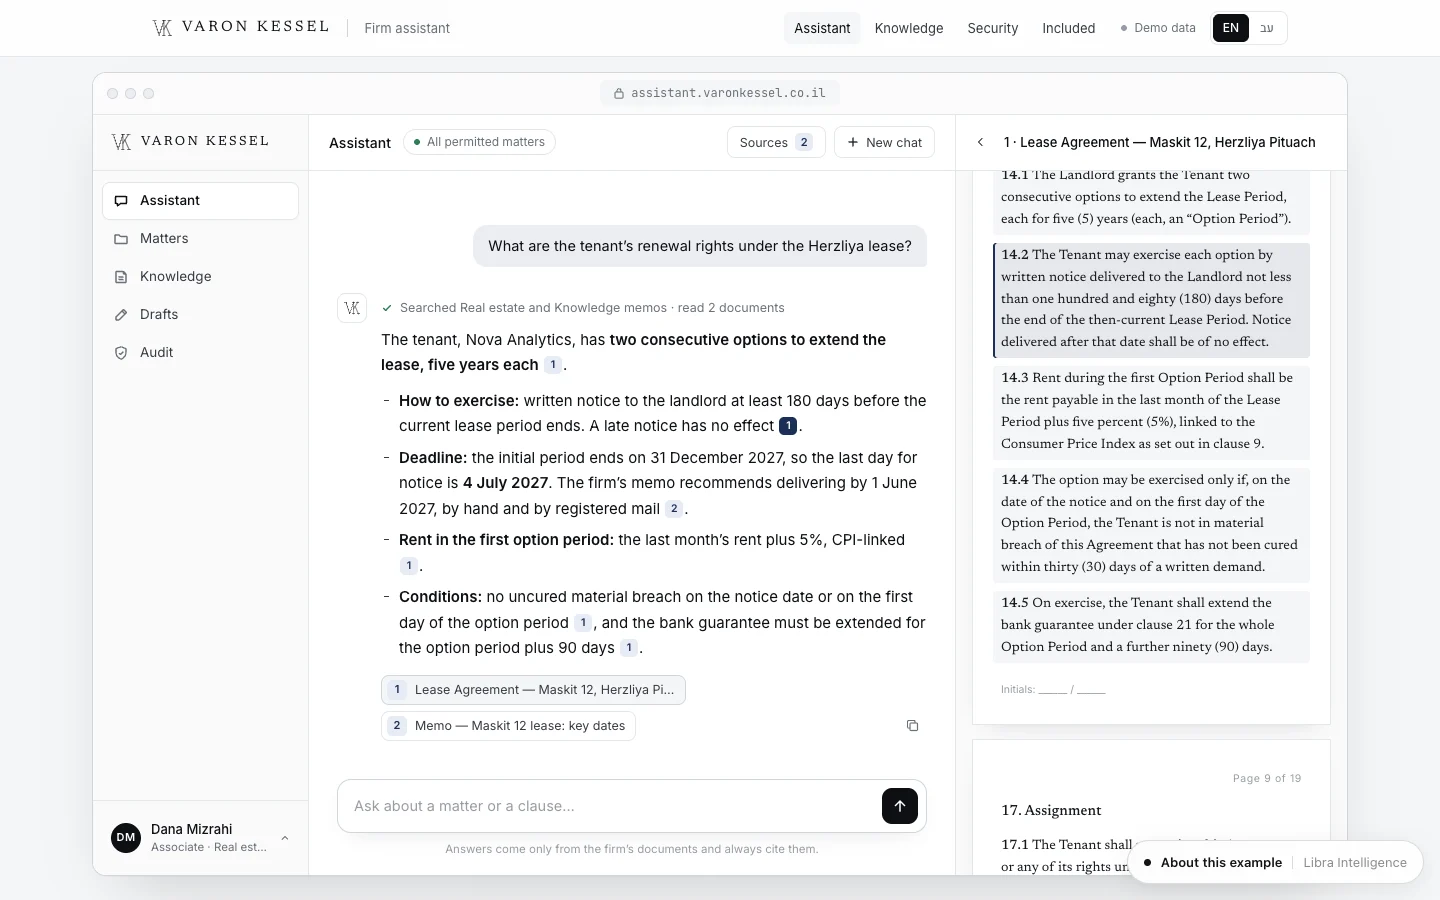
עוזר שעונה בלי מקור מבקש שיסמכו עליו. עוזר שמראה את הסעיף, המסמך והתאריך מאפשר לבדוק בשניות. עוזר ה־AI של Varon Kessel הוא קונספט שבנינו למשרד עורכי דין בדוי: הוא עונה מתוך המסמכים של המשרד, וכל תשובה מציגה את המקורות שלה עם קישור לקטע. זה הסטנדרט שכדאי לדרוש, ובתחומים כמו משפט, רפואה או כספים הוא הכרחי. איך עוזר כזה משתלב באתר של משרד עורכי דין כתבנו במאמר על בניית אתר לעורך דין.
בדיקות לפני שעולים: סט של שאלות אמיתיות
לפני שהעוזר פתוח לצוות, בונים סט בדיקה: כמה עשרות שאלות אמיתיות שאנשים בעסק שואלים, ולכל אחת התשובה הנכונה והמסמך שהיא נמצאת בו. את הסט מריצים אחרי כל שינוי במסמכים, בחיתוך או במודל.
- שאלות פשוטות שהתשובה להן בסעיף אחד.
- שאלות שהתשובה להן מפוזרת בשני מסמכים.
- שאלות בניסוח אחר מהמסמך, בעברית ובאנגלית, עם שגיאות כתיב.
- שאלות שאין להן תשובה במסמכים, כדי לבדוק שהעוזר אומר שאין.
- שאלות ממשתמש בלי הרשאה, כדי לבדוק שהוא לא מקבל את התשובה.
לכל תשובה בודקים שלושה דברים: שהיא נכונה, שהמקור שצוין באמת אומר את זה, ושלא נוסף בה משהו שלא כתוב במקור.
כשאין תשובה: טיפול בהזיות
מודל שפה יכול לנסח תשובה בטוחה בלי בסיס. RAG מצמצם את זה, אבל לא מבטל. מה שעובד:
- הוראה ברורה לענות רק מהקטעים שנשלפו, ולומר ״לא מצאתי במסמכים״ כשהם לא עונים.
- סף: אם הקטעים שנמצאו רחוקים מהשאלה, העוזר לא עונה אלא מפנה לאדם.
- ציטוט חובה, כך שתשובה בלי מקור בולטת מיד.
- כפתור ״התשובה לא נכונה״ שמגיע למי שאחראי על המסמכים.
- קריאה שבועית של מדגם שאלות ותשובות, ותיקון של המסמכים, לא רק של ההוראות.
אבטחה: הזרקת הוראות ומסמכים מורעלים
OWASP מציבה את הזרקת הוראות (prompt injection) במקום הראשון ברשימת הסיכונים ליישומי מודלי שפה ל־2025 (LLM01). בעוזר על מסמכים הסכנה העיקרית היא העקיפה: מסמך, מייל או עמוד אינטרנט שנכנס לאינדקס ומכיל טקסט שמנסה לשנות את התנהגות המודל. OWASP מציינת במפורש ש־RAG לא מבטל את הסיכון הזה, וממליצה בין השאר על הרשאות מינימליות, הפרדה של תוכן חיצוני ואישור אנושי לפעולות רגישות.
- להכניס לאינדקס רק מקורות מוכרים, ולסמן תוכן שמגיע מבחוץ (מיילים של לקוחות, מסמכים שהועלו).
- עוזר שעונה בלבד, בלי כלים לשלוח, למחוק או לשנות, מקטין מאוד את הנזק האפשרי.
- אם יש לו כלים, כל פעולה רגישה עוברת אישור של אדם.
- תיעוד של כל שאלה, הקטעים שנשלפו והתשובה, כדי לבדוק מה קרה.
איפה הנתונים נמצאים
בעוזר כזה המסמכים עוברים דרך כמה רכיבים: האחסון שלהם, האינדקס, ספק מודל השפה והיישום עצמו. לכל אחד כדאי לדעת איפה הוא רץ, כמה זמן נשמר מידע ומי יכול לגשת. אצל ספקי מודלים, התנאים לשימוש עסקי שונים מהתנאים לצרכן. Anthropic, למשל, כותבת שכברירת מחדל היא לא משתמשת בקלט ובפלט של המוצרים המסחריים שלה, כולל ה־API, לאימון מודלים (מרכז הפרטיות של Anthropic). בכל ספק תבדקו את זה בתנאים שלו, ובמידע רגיש גם עם עורך דין לפרטיות.
עוזר פנימי או עוזר ללקוחות?
| עוזר פנימי לצוות | עוזר ללקוחות באתר או בוואטסאפ | |
|---|---|---|
| עונה מ | נהלים, חוזים, ידע מקצועי, היסטוריה | מידע ציבורי בלבד: שאלות נפוצות, מדיניות, מוצרים |
| הרשאות | לפי תפקיד וצוות, חובה | כולם רואים אותו ידע, ולכן לא נכנס אליו שום דבר פנימי |
| סיכון עיקרי | דליפה בין משתמשים | תשובה שגויה שנשמעת כמו התחייבות של העסק |
| כשאין תשובה | מפנה למסמך או לאדם בצוות | מעביר לאדם עם סיכום השיחה |
| מתחילים כש | אותן שאלות חוזרות לאותם אנשים | רוב הפניות הן שאלות מידע שהתשובה להן כתובה |
כדאי להתחיל בפנימי: הקהל סלחן יותר, קל לאסוף משוב, והצוות מגלה מהר אילו מסמכים חסרים או סותרים. עוזר שגם מבצע פעולות, כמו קביעת תור, הוא כבר סוכן; הסוכן של EMBER הוא דוגמה כזו שבנינו למסעדה בדויה. כשהעוזר מחובר ל־CRM, הוא יכול לענות גם על היסטוריית לקוח, בכפוף להרשאות; על בחירת CRM כתבנו במדריך ל־CRM לעסק קטן.
כמה עולה עוזר AI על מסמכי החברה?
טווחים שאנחנו רואים בשוק הישראלי, לא מחירון, לפני מע״מ: עוזר על מאגר מסמכים אחד, בלי הרשאות מורכבות, עם ציטוט מקורות וסט בדיקה, הוא בערך 10,000 עד 30,000 ₪. עוזר עם הרשאות לפי משתמש, חיבור לכונן או למערכת המסמכים, עדכון אוטומטי של האינדקס ותיעוד מלא מתחיל בדרך כלל בערך ב־30,000 ₪. המחיר תלוי בכמות המסמכים ובמצבם, בסוגי הקבצים, בהרשאות, בשפות ובמספר המשתמשים. מעל זה יש עלות שוטפת: שימוש במודל לפי כמות, אחסון ואינדקס, ותחזוקה של הידע.
רשימת בדיקה לפני שבונים
- לאסוף 30 עד 50 שאלות אמיתיות שחוזרות בעסק, עם התשובות הנכונות.
- למפות את המסמכים שעונים עליהן, ולסמן גרסאות ישנות וסותרות.
- להחליט מי אחראי על כל מאגר מסמכים ועל עדכונו.
- להגדיר הרשאות: מי רואה מה, לפי ההרשאות שכבר קיימות.
- לדרוש ציטוט מקור בכל תשובה.
- להגדיר מה העוזר אומר כשאין תשובה, ולמי הוא מפנה.
- לבדוק איפה נשמרים הנתונים ומה התנאים של ספק המודל לשימוש עסקי.
- להריץ את סט הבדיקה לפני העלייה ואחרי כל שינוי.
- להתחיל בקבוצה קטנה בצוות, ולקרוא את השאלות בשבועות הראשונים.
מה Libra בונה כאן
ב־Libra אנחנו בונים עוזרי AI שעונים מתוך המסמכים של העסק, עם ציטוט מקור בכל תשובה, הרשאות לפי משתמש, סט בדיקה ותיעוד, לצוות פנימי או ללקוחות. הפירוט בעמוד אוטומציה וסוכני AI. שלחו בריף עם סוג המסמכים, איפה הם נשמרים היום, מי ישתמש בעוזר וכמה דוגמאות לשאלות שחוזרות. נחזור במייל עם כיוון, מחיר בכתב ותאריך.
לא נמצא מונח כזה.
שאלות נפוצות
אפשר לבנות צ׳אטבוט שעונה מתוך המסמכים של החברה?
כן. בשיטת RAG העוזר מחפש בכל שאלה את הקטעים הרלוונטיים במסמכים, נותן אותם למודל שפה ומבקש לענות רק מהם, עם הפניה למקור.
מה זה RAG?
Retrieval-Augmented Generation: המערכת שולפת קטעים רלוונטיים ממאגר מסמכים ומודל השפה מנסח תשובה על בסיסם. כך אפשר להראות מקור ולעדכן ידע בלי לאמן מודל מחדש.
צריך לאמן מודל על המסמכים שלנו?
ברוב המקרים לא. אחזור (RAG) עדיף לידע שמשתנה, כי הוא מאפשר מקורות, הרשאות ועדכון מיידי. אימון מתאים לסגנון או לפורמט, לא לעובדות.
איך מונעים מהעוזר להמציא תשובות?
מורים לו לענות רק מהקטעים שנשלפו, מחייבים ציטוט מקור, מגדירים סף שמתחתיו הוא מפנה לאדם, ובודקים אותו על סט שאלות אמיתיות. הסיכון קטן מאוד אבל לא נעלם.
עובד שאין לו הרשאה יכול לקבל מידע חסוי מהעוזר?
רק אם ההרשאות לא נבנו נכון. ההרשאות צריכות להיאכף בשלב החיפוש לפי המשתמש המחובר, ולא על ידי הוראה למודל.
המסמכים שלנו ישמשו לאימון מודלים של הספק?
זה תלוי בתנאים של הספק. חלק מהספקים, למשל Anthropic, כותבים שכברירת מחדל הם לא מאמנים על נתונים ממוצרים מסחריים; תבדקו את זה בתנאים של הספק שבו משתמשים.
כמה עולה עוזר AI על מסמכים?
בשוק הישראלי עוזר על מאגר אחד עם ציטוט מקורות הוא בערך 10,000 עד 30,000 ₪, ועם הרשאות וחיבורים מתחיל בערך ב־30,000 ₪, ועוד עלות שימוש שוטפת.
להתחיל
רוצים את זה לעסק שלכם?
שלחו בריף קצר: שלוש שאלות חובה, והשאר רק אם בא לכם. חוזרים במייל עם כיוון, מחיר ותאריך כתובים.